Dados: coleta, modelagem e qualidade · 2026
Mapa de vagas
de dados
Coleta, integração e leitura crítica de 2.822 anúncios em Gupy, LinkedIn e RemoteOK
- Minha contribuição
- Direção do projeto e decisões de classificação.
- Entrega
- Base de 2.822 registros; figuras, relatório e scripts públicos.
- Coletas
- Gupy em 26/09/26; LinkedIn e RemoteOK em 07/10/26
Base harmonizada: 30/10/26
O que as vagas de dados pedem? Foi pra responder isso que juntei anúncios da Gupy, do LinkedIn e do RemoteOK.
SQL, Python e Power BI são as competências mais citadas nas três fontes. Mas o peso de cada uma muda com a família de cargo (análise e BI, ciência de dados, engenharia de dados e por aí vai). Na Gupy, que tem descrição em todas as vagas, fica assim:
- Análise e BI: SQL lidera (77,5% contra 59,6% de Python).
- Ciência de dados: Python lidera (93,0% contra 67,4% de SQL).
- Engenharia de dados: cita os dois na mesma medida (78,9% cada).
Aí vem a segunda parte da resposta, até onde dá pra comparar as fontes. Python aparece em 57,1% das descrições da Gupy e em 57,2% das do LinkedIn. Empate? Separa por família e ele some: em ciência de dados, é 93,0% contra 68,3%. O empate vem da cobertura. Só 236 das 1.209 vagas do LinkedIn têm descrição, e quase todas são de análise e BI ou ciência de dados.
Este case conta como cheguei até aqui, da coleta à decisão sobre o que dava pra comparar.
A base final tem 2.822 registros, e cada um guarda origem, ID, arquivo de coleta (snapshot), se tem descrição e como foi classificado. Depois da classificação, 1.719 anúncios entraram no recorte de vagas de dados. Os outros 1.103 ficaram marcados como fora do escopo, sem sumir do arquivo.
Três coletas, três problemas
A Gupy veio primeiro, em 26/09/26, e já com uma pegadinha. Com limit=100, a API informa total=100. Só que o total real de "analista de dados" era 248, e a primeira rodada parou cedo por isso. O coletor passou a paginar até a API parar de devolver vagas e fechou em 1.208 IDs. Desses, 1.022 entram aqui: contratos efetivo, PJ e temporário, publicados nos 90 dias antes da coleta.
LinkedIn e RemoteOK são de 07/10/26. O LinkedIn trouxe 1.318 anúncios de sete países: Brasil, Portugal, Canadá, Estados Unidos, Reino Unido, Alemanha e Espanha.
O RemoteOK ↗ trouxe 482 e deu mais trabalho do que o tamanho sugere. Tinha "Camareira de Hotel" rotulada como Brasil e "Human Resources Specialist" como análise e BI. Das 169 vagas com esse rótulo, 148 saíram do recorte com a regra comum. E o coletor marcava EUA quando não reconhecia a localização, então os 346 registros com esse país são um palpite do script.
O que cada fonte deixa ver
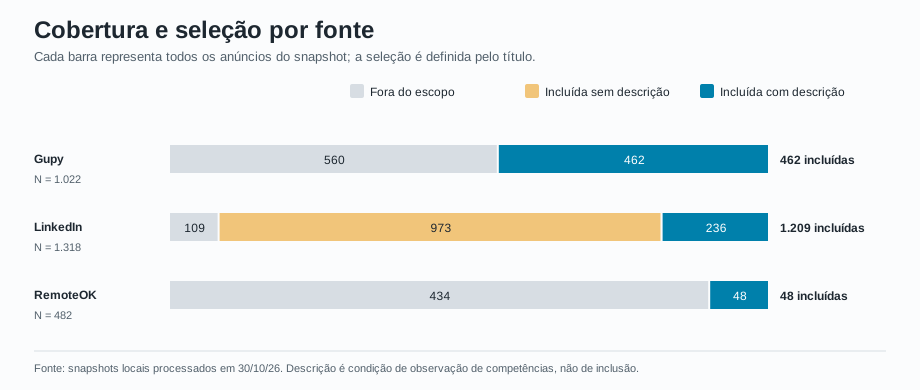
A Gupy tem descrição em todas as 462 vagas incluídas. O RemoteOK também, nas suas 48, com 25 textos cortados. No LinkedIn, são 236 de 1.209, e 139 desses estão cortados.
E a falta de texto no LinkedIn não é aleatória. Só tem texto de três países (Brasil 86 de 213, Portugal 94 de 200, Canadá 56 de 140). Estados Unidos, Reino Unido, Alemanha e Espanha ficam em zero. Por família, análise e BI tem 125 de 389, ciência de dados 101 de 405 e engenharia de dados só 10 de 284. IA, pesquisa e governança não têm nenhum. Por que a captura parou nesses recortes? Não sei. Não localizei nos logs a execução dessa etapa.
Uma vaga sem descrição não é uma vaga com zero competências. Por isso, toda porcentagem de competência aqui conta só as vagas incluídas com texto. O formato n/N mostra quantas citam a competência (n) entre as que têm texto (N).
Uma regra só para as três fontes
A harmonização é a etapa que coloca as três fontes sob a mesma regra. Ela mantém uma linha por fonte + id_origem, preserva o dado original e acrescenta família, inclusão no recorte, senioridade e competências mencionadas. São seis famílias: análise e BI, ciência de dados, engenharia de dados, governança e qualidade, IA, e pesquisa e inteligência. A classificação parte do título, com regras determinísticas, ou seja, o mesmo título sempre cai na mesma família. E qualquer pessoa pode auditar essas regras no repositório.
A releitura pegou erros do classificador antigo. A regex de Excel não tinha limite de palavra e capturava "excelência". Na primeira análise da Gupy (o recorte histórico, com 752 vagas), 117 registros marcados com Excel não tinham a palavra. E "Projeto Internacional" virava estágio, porque intern casava com o começo de "Internacional".
Depois li uma amostra estratificada de 26 itens, uma vaga por fonte e família mais três exclusões por fonte. Ela pegou títulos que ficavam de fora por idioma ou grafia, como Engenheiro(a) de Dados, Analyste BI, Científico de datos e Power BI / Dashboard UI Specialist. As regras foram corrigidas a partir disso. A amostra serve pra achar defeito. Taxa de erro ela não estima.
Deixei um erro de propósito. Senior Analyst fica fora do recorte mesmo quando a descrição mostra que a função envolve dados. Usar a descrição pra classificar favoreceria justo o pedaço do LinkedIn que tem texto, e eu prefiro perder essas vagas a criar esse viés.
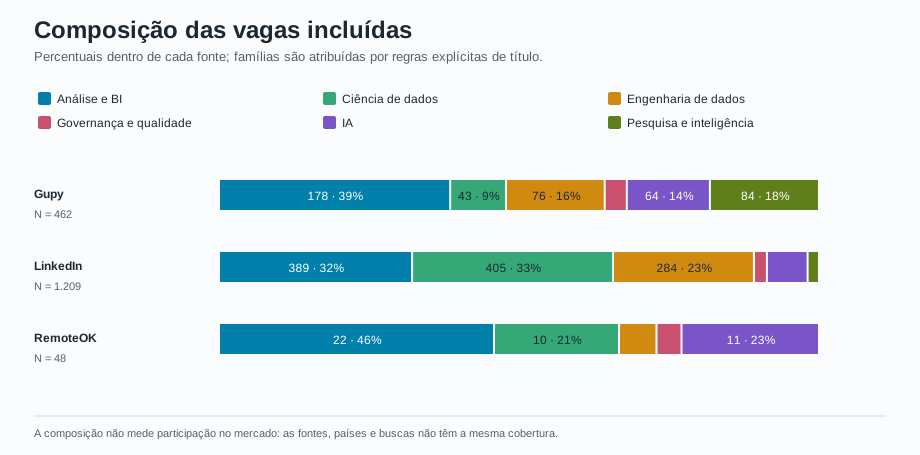
As fontes misturam famílias em proporções diferentes, então não medem a mesma coisa. Na Gupy, análise e BI reúne 178 vagas, seguida de pesquisa e inteligência (84), engenharia de dados (76) e IA (64). O LinkedIn concentra ciência de dados (405), análise e BI (389) e engenharia de dados (284). Esses números descrevem os snapshots e as regras. Sobre o tamanho de cada família no mercado, não dizem nada.
O empate que some
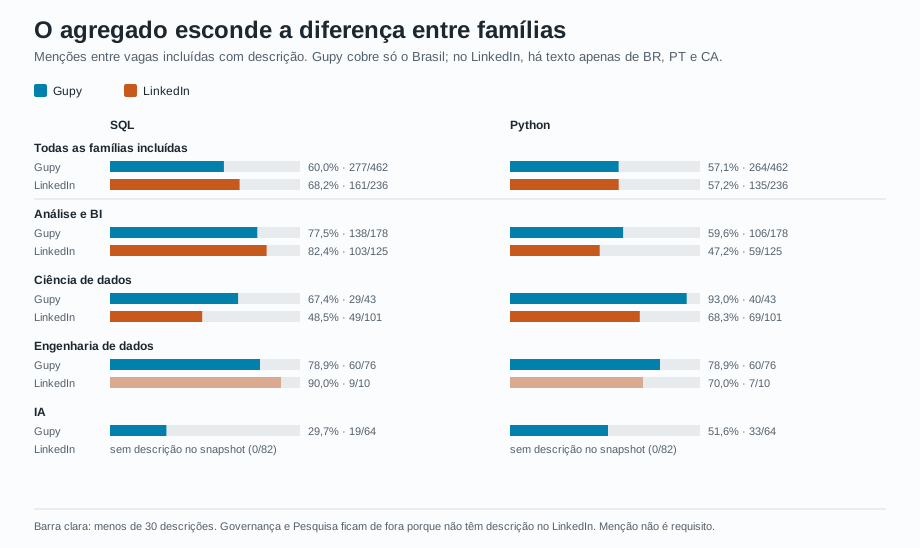
Na linha de cima, a comparação parece resolvida: Python empatado, SQL um pouco à frente no LinkedIn (68,2% contra 60,0%). Abrindo por família, o Python desempata em análise e BI (59,6% contra 47,2%) e em ciência de dados (93,0% contra 68,3%). E o SQL muda de lado: em ciência de dados, a Gupy passa à frente, com 67,4% contra 48,5%.
A explicação está em quais famílias têm texto. Na Gupy, 165 das 462 descrições são de IA, pesquisa ou governança, famílias em que Python cai pra 35,2% e SQL pra 30,3%. No LinkedIn, essas famílias não têm descrição nenhuma, e 226 das 236 vêm de análise e BI ou de ciência de dados. O resultado geral da Gupy desce por causa de vagas que o LinkedIn não tem como mostrar. O empate é coincidência: as duas fontes misturam famílias diferentes.
O que sobra de diferença mistura plataforma e país (Gupy só com Brasil, LinkedIn com Brasil, Portugal e Canadá), então eu não chamaria isso de diferença de mercado. E engenharia de dados no LinkedIn, com 10 descrições, não sustenta conclusão nenhuma.
A comparação mais limpa é dentro da Gupy, onde todas as vagas têm texto. Nela, Python sobe de 59,6% em análise e BI para 93,0% em ciência de dados. Engenharia de dados cita SQL e Python em igual medida (78,9% cada).
"Menção" aqui é a palavra aparecer no texto. A ferramenta pode estar ali como requisito, diferencial ou tecnologia do time, e a medida só registra que ela apareceu.
Trabalho remoto e salário
Usei o State of Data Brazil 2025-2026 ↗ como contexto externo, sem misturar respondentes com anúncios.
A distância é grande. Entre os profissionais que responderam à pesquisa (coleta de outubro a dezembro de 2025), 39,6% trabalham 100% remotamente. Entre as 462 vagas da Gupy (publicadas de junho a setembro de 2026), 90 são remotas, ou 19,5%. No recorte histórico da primeira análise, mais amplo em famílias, eram 111 de 752 (14,8%). Pessoas empregadas e anúncios abertos são populações diferentes, em datas diferentes, então eu registro a diferença e paro aí. Ela não mede queda do trabalho remoto. O RemoteOK fica fora dessa conta, porque é um canal escolhido por ser remoto.
Eu também queria salário. Foi o pedido que originou o projeto, e os dados não deixaram. No recorte histórico da Gupy, o script detectou só 6 faixas. O LinkedIn tem só textos soltos de salário, e o RemoteOK tem os campos numéricos vazios no snapshot. Moeda, período e senioridade não estão validados, então ficou de fora.
Método e rastreabilidade
Os artefatos usados para chegar aos gráficos estão no repositório público ↗. Rodar a harmonização de novo, sem nova coleta de anúncios, produziu arquivos idênticos (mesmos hashes). A base linha a linha e os arquivos de coleta não são públicos, porque os termos de uso do LinkedIn e da Gupy restringem copiar e distribuir esse conteúdo.
- Relatório da harmonização ↗, com critérios e contagens.
- Tabelas e figuras ↗, incluindo as menções de onze competências por fonte.
- Scripts
harmonizar.py↗,validar_amostra.py↗ egerar_figuras.py↗.
O que esta base não responde
A base não mede o mercado brasileiro de dados. São três fontes com coberturas distintas, classificadas por título e com parte dos textos cortada. A mesma vaga pode aparecer em mais de uma plataforma, porque não houve deduplicação semântica entre elas.
Onde olhar numa comparação dessas: antes da porcentagem, no denominador. Quantas vagas têm texto, e de quais famílias.
Feito com Claude Code: eu dirigi o projeto e tomei as decisões de classificação; a coleta da Gupy, a harmonização, as figuras e o rascunho deste texto foram feitos com a ferramenta. Editei o texto linha a linha e assino.